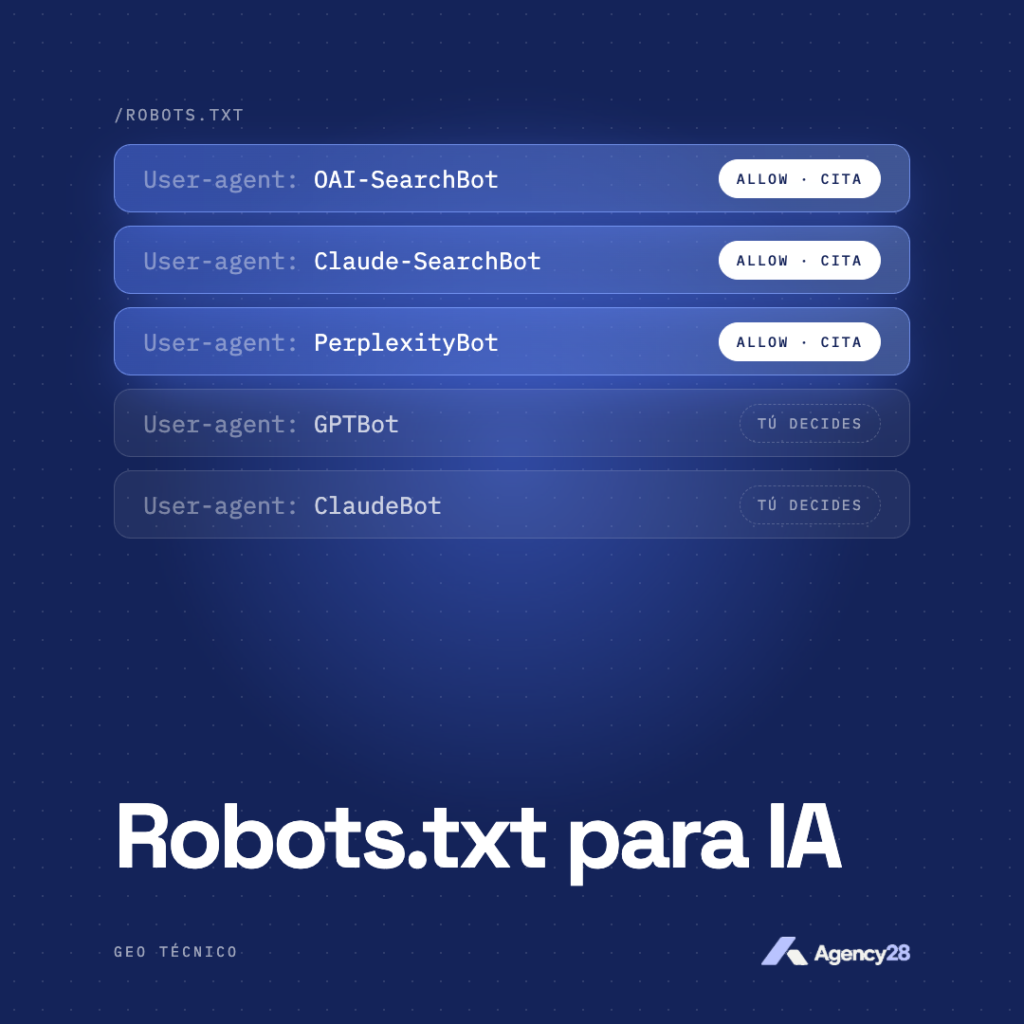
El robots.txt es el archivo que decide qué bots pueden leer tu web, y eso incluye a los de ChatGPT, Claude, Perplexity y Gemini. Para que la IA pueda citarte, tienes que dejar pasar a sus bots de búsqueda (OAI-SearchBot, Claude-SearchBot, PerplexityBot) y a los que visitan tu web cuando un usuario lo pide (ChatGPT-User, Claude-User). Los bots de entrenamiento (GPTBot, ClaudeBot, Google-Extended) son otra decisión: bloquearlos te saca del entrenamiento, no necesariamente de las respuestas. El error más común es bloquear uno creyendo que bloqueas otro.
◆ Puntos clave
- Cada empresa de IA usa varios bots con funciones distintas: entrenamiento, búsqueda y peticiones de usuario.
- Para aparecer en las respuestas importan sobre todo los bots de búsqueda, no los de entrenamiento.
- Bloquear GPTBot no te saca de ChatGPT, y bloquear ClaudeBot no te saca de Claude.
- El robots.txt no es la única barrera: Cloudflare o tu firewall pueden bloquear bots de IA sin que lo sepas.
Muchas webs son invisibles para la IA por un motivo que no tiene nada que ver con su contenido: un par de líneas en un archivo de texto que nadie revisa. A veces es una regla copiada de una lista de 2023, a veces un bloqueo heredado de la versión de pruebas y a veces una decisión tomada a medias, pensando que se bloqueaba el entrenamiento y cerrando también la puerta a las citas. Este es el primer punto que revisamos en la auditoría GEO, porque si los bots no pueden entrar, nada de lo demás importa.
Por qué el robots.txt decide si la IA puede citarte
Los asistentes de IA que buscan en la web funcionan de forma parecida a un buscador: un bot visita tu página, la guarda en un índice y, cuando alguien pregunta, el asistente elige entre las fuentes de ese índice. Si tu robots.txt le prohíbe la entrada a ese bot, tu página no entra en el índice y no puede salir como fuente.
Los bots de las grandes empresas de IA respetan el robots.txt. Anthropic, por ejemplo, documenta que desactivar sus bots de búsqueda o de usuario puede reducir tu visibilidad en las búsquedas que hacen sus usuarios. Es decir: el archivo funciona, y precisamente por eso un error en él tiene consecuencias.
Los 3 tipos de bots de IA (y cuáles importan para tu visibilidad)
La clave para no equivocarte es entender que cada empresa de IA no tiene un bot, sino varios, y cada uno hace una cosa distinta.
| Tipo | Qué hace | Ejemplos | Si lo bloqueas |
|---|---|---|---|
| Entrenamiento | Recoge contenido que puede usarse para entrenar modelos | GPTBot, ClaudeBot, Google-Extended | Tu contenido sale del entrenamiento futuro |
| Búsqueda y citas | Indexa páginas para que el asistente las use como fuente | OAI-SearchBot, Claude-SearchBot, PerplexityBot | Dejas de poder aparecer como fuente citada |
| Petición de usuario | Visita una página concreta cuando un usuario se lo pide al asistente | ChatGPT-User, Claude-User | El asistente no puede leer tu web aunque el usuario lo pida |
Bots de entrenamiento
Recogen contenido que puede acabar en los datos con los que se entrenan los modelos. Permitirlos ayuda a que el modelo «conozca» tu marca, pero no garantiza citas, porque las citas salen de la búsqueda en tiempo real. Bloquearlos es una decisión legítima si no quieres que tu contenido se use para entrenar.
Ojo con Google-Extended: no es un bot que visite tu web, sino una señal que le dice a Google qué puede hacer con lo que ya ha rastreado Googlebot. No afecta a tu posicionamiento en Google ni a AI Overviews, que dependen de Googlebot. Pero según la documentación que recogen varias fuentes, además del entrenamiento cubre el uso de tu contenido como fuente en las respuestas de Gemini. Si lo bloqueas, puedes perder citas en Gemini.
Bots de búsqueda y citas
Son los que deciden si apareces. OAI-SearchBot construye el índice de la búsqueda de ChatGPT, Claude-SearchBot hace lo mismo para Claude y PerplexityBot para Perplexity. Si quieres que la IA te recomiende, estos no se bloquean. Tienes más detalle sobre cada plataforma en las guías para aparecer en ChatGPT y aparecer en Perplexity.
Bots de petición de usuario
Entran cuando una persona le pide al asistente que consulte una web, por ejemplo pegando tu URL en el chat. Conviene permitirlos. Un matiz: OpenAI indica que, como estas visitas las inicia un usuario, el robots.txt puede no aplicarse a ChatGPT-User. Anthropic, en cambio, dice que Claude-User sí respeta el robots.txt.
El error que deja a muchas webs fuera de ChatGPT
Pasa constantemente: alguien lee que «hay que bloquear a la IA para proteger el contenido», añade GPTBot y ClaudeBot al robots.txt y se queda tranquilo. Ese bloqueo solo afecta al entrenamiento. Las citas siguen llegando por OAI-SearchBot y Claude-SearchBot.
El caso contrario es todavía más dañino: alguien quiere salir del entrenamiento, copia una lista larga de bots «de IA» y bloquea también los de búsqueda. Resultado: la web desaparece de las respuestas de ChatGPT, Claude y Perplexity, y nadie sabe por qué.
Bloquear el bot de entrenamiento te protege. Bloquear el bot de búsqueda te borra.
El robots.txt que recomiendo
Esta configuración permite todos los bots que sirven para aparecer en respuestas de IA y deja los de entrenamiento permitidos, que es lo que recomiendo para una empresa que quiere visibilidad. Si prefieres salir del entrenamiento, cambia Disallow: /wp-admin/ por Disallow: / solo en el último grupo.
# Reglas generales para todos los bots
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

# Bots de búsqueda y de usuario: permitir (aparecer en respuestas de IA)
User-agent: OAI-SearchBot
User-agent: ChatGPT-User
User-agent: Claude-SearchBot
User-agent: Claude-User
User-agent: PerplexityBot
Disallow: /wp-admin/

# Bots de entrenamiento: decisión tuya (aquí, permitidos)
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
Disallow: /wp-admin/

Sitemap: https://tudominio.com/sitemap.xml
Dos detalles que conviene entender. Primero, un bot que tiene su propio grupo ignora las reglas del grupo general (User-agent: *), por eso repetimos Disallow: /wp-admin/ en cada grupo. Segundo, cambia la línea Sitemap por la URL real de tu sitemap; si usas Yoast, suele ser /sitemap_index.xml.
En WordPress: si no hay un archivo físico, WordPress genera un robots.txt virtual. Puedes crear el archivo en la carpeta raíz por FTP o desde el administrador de archivos de tu hosting, o editarlo desde el plugin SEO que uses si incluye un editor de robots.txt.
Cómo revisar tu robots.txt en 5 minutos
Ábrelo
Entra en tudominio.com/robots.txt desde el navegador y comprueba que carga.
Busca bloqueos
Localiza cualquier Disallow: / bajo un bot de IA o bajo User-agent: *.
Revisa el firewall
Comprueba si Cloudflare o tu hosting bloquean bots de IA por su cuenta.
Presta especial atención a un User-agent: * seguido de Disallow: /. Es típico de webs que se lanzaron desde un entorno de pruebas sin quitar el bloqueo, y deja fuera a todos los bots que no tengan un grupo propio.
Si quieres confirmar que los bots están entrando de verdad, revisa los logs de tu servidor y busca sus nombres en el campo user-agent. Es la única forma directa de verlo; no hay un panel oficial de las empresas de IA que te lo diga.
¿No sabes si tu web o tu Cloudflare están bloqueando bots de IA? La auditoría GEO gratis revisa las dos cosas y te dice qué cambiar.
Cuando el robots.txt no basta: Cloudflare y firewalls
Puedes tener un robots.txt perfecto y seguir siendo invisible. Los servicios de seguridad como Cloudflare filtran el tráfico antes de que llegue a tu web, y el bot ni siquiera llega a leer el archivo. Cloudflare bloquea por defecto bots de IA conocidos en los dominios nuevos desde 2025, y en julio de 2026 cambió sus ajustes para distinguir entre bots de búsqueda, de agente y de entrenamiento. Desde el 15 de septiembre de 2026, en los dominios nuevos bloquea por defecto los de entrenamiento y los de agente en las páginas que muestran anuncios, y deja pasar los de búsqueda. Los bots que visitan tu web a petición de un usuario, como ChatGPT-User o Claude-User, encajan en la categoría de agente. Si tu web pasa por Cloudflare, revisa la configuración de bots de IA en su panel: puede que estés bloqueando más de lo que crees.
Lo mismo aplica a plugins de seguridad y a reglas del hosting que bloquean por IP o por volumen de peticiones. Anthropic advierte que bloquear sus IPs puede impedir que su bot lea tu robots.txt, así que si quieres controlar el acceso, hazlo en el robots.txt y no en el firewall.
Una vez que los bots pueden entrar, el siguiente paso es decirles qué leer. Para eso sirve el archivo llms.txt: el robots.txt da permiso, el llms.txt da contexto.
Errores frecuentes
| Error | Consecuencia |
|---|---|
| Bloquear GPTBot o ClaudeBot creyendo que bloqueas el asistente | Solo sales del entrenamiento; las citas siguen igual |
| Copiar una lista de «bots de IA» sin distinguir tipos | Bloqueas también los de búsqueda y desapareces de las respuestas |
Dejar un Disallow: / heredado de la versión de pruebas | Ningún bot sin grupo propio puede leer la web |
| Usar listas antiguas | Faltan bots nuevos como OAI-SearchBot o Claude-SearchBot, y sobran nombres retirados como anthropic-ai o Claude-Web |
| Bloquear Google-Extended sin saber qué cubre | Puedes perder citas en Gemini, no solo el entrenamiento |
| Revisar el robots.txt y olvidar Cloudflare | El firewall bloquea antes de que el bot lea el archivo |
Checklist
Sigue profundizando
El robots.txt es la primera pieza de la capa técnica del GEO. Después, guía a los bots con el llms.txt y revisa el resto de puntos en la guía para hacer una auditoría GEO paso a paso. Si estás empezando, lee primero qué es el GEO.
Si prefieres que lo revisemos por ti, la auditoría GEO gratis comprueba tu robots.txt, tu firewall y otros 20 puntos que influyen en si la IA te recomienda.
Preguntas frecuentes
¿Debo bloquear GPTBot?+
Depende de si quieres que tu contenido se use para entrenar modelos de OpenAI. Bloquearlo no te saca de las respuestas de ChatGPT, porque la búsqueda funciona con OAI-SearchBot. Para una empresa que busca visibilidad, lo habitual es permitirlo.
¿Si bloqueo GPTBot desaparezco de ChatGPT?+
No. GPTBot es el bot de entrenamiento. Lo que te hace aparecer como fuente en ChatGPT es OAI-SearchBot, y las visitas que pide un usuario las hace ChatGPT-User. Son reglas independientes en el robots.txt.
¿Qué diferencia hay entre ClaudeBot y Claude-SearchBot?+
ClaudeBot recoge contenido para el entrenamiento de los modelos de Claude. Claude-SearchBot indexa páginas para mejorar los resultados de búsqueda de Claude. Si bloqueas solo ClaudeBot, sigues pudiendo aparecer en las respuestas.
¿Google-Extended afecta a AI Overviews?+
No. AI Overviews usa el índice normal de Googlebot. Google-Extended controla el uso de tu contenido para entrenar Gemini y como fuente en las respuestas de Gemini, así que bloquearlo sí puede afectar a tus citas en Gemini.
¿Todos los bots de IA respetan el robots.txt?+
Los de las grandes empresas de IA sí lo respetan, con matices en los bots que actúan a petición del usuario. Los scrapers sin identificar lo ignoran: contra esos se usan reglas de firewall o límites de peticiones, no el robots.txt.
¿Con esto ya apareceré en las respuestas de la IA?+
No por sí solo. El robots.txt es una condición necesaria: sin acceso no hay citas. Pero que la IA te recomiende depende también de tu entidad de marca, tus reseñas y de tener contenido claro y citable.
Fuentes
- Overview of OpenAI crawlers — OpenAI. GPTBot, OAI-SearchBot y ChatGPT-User, y cómo controlarlos.
- Does Anthropic crawl data from the web, and how can site owners block the crawler? — Anthropic. ClaudeBot, Claude-SearchBot y Claude-User, y efecto de bloquear cada uno.
- Perplexity crawlers — Perplexity. Nombres y funciones de los rastreadores de Perplexity.
- Introduction to robots.txt — Google Search Central. Qué controla el robots.txt y cómo funciona.
- ai.robots.txt — Proyecto comunitario en GitHub. Lista actualizada de user agents de IA.
- List of Google’s common crawlers — Google. Google-Extended: token sin user agent propio que no afecta a la inclusión ni al ranking en Google Search.
- New options to manage AI traffic — Cloudflare, julio de 2026. Categorías Search, Agent y Training, y nuevos valores por defecto desde el 15 de septiembre de 2026.
¿Quieres saber cómo te ve la IA hoy?
Te hacemos una auditoría GEO gratuita: dónde apareces, dónde no, y qué haría falta para ser la respuesta.